基于Python爬虫技术的歌曲数据分析与推荐系统设计与实现
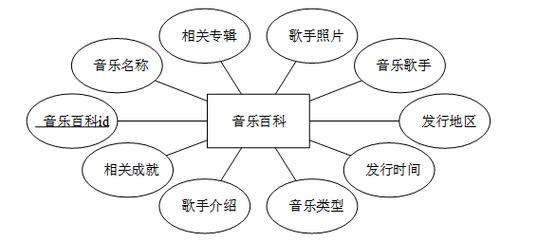
摘要\n\n随着数字音乐平台的高速发展,用户面临着海量歌曲信息的选择困境。本文设计并实现了一个基于Python爬虫技术的歌曲数据分析与推荐系统。系统首先通过Scrapy与Requests等爬虫框架,从公开音乐平台采集歌曲的元数据、歌词及用户行为数据;随后利用Pandas、NumPy等工具进行数据清洗、特征提取与统计分析;在此基础上,结合基于内容的推荐算法与协同过滤算法构建混合推荐模型,并通过Flask框架提供Web服务接口,实现歌曲检索、数据可视化与个性化推荐功能。实验结果表明,该系统能够有效整合多源音乐数据,并在推荐准确率与用户体验方面取得较好效果。\n\n## 一、引言\n\n数字音乐已成为大众文化消费的重要形式,主流音乐平台积累了海量的歌曲与用户行为数据。如何从这些数据中挖掘有价值的规律,并为用户提供精准的歌曲推荐,是计算机系统服务领域的一个典型应用场景。Python凭借其丰富的爬虫生态、数据分析库和机器学习框架,非常适合作为此类系统的开发语言。本文围绕歌曲数据的采集、分析与推荐展开系统化设计与实现,旨在构建一个可运行、可扩展的完整系统。\n\n## 二、系统需求分析\n\n系统主要面向三类需求:\n\n1. 数据采集需求:能够从目标音乐平台稳定抓取歌曲基本信息(歌名、歌手、专辑、时长、发行时间)、歌词文本以及播放量、评论数等热度指标。\n2. 数据分析需求:对采集数据进行清洗去重、缺失值处理,并完成歌曲热度排名、歌手分布、曲风分布、歌词关键词提取等统计分析。\n3. 推荐服务需求:根据用户的历史听歌记录或当前选定的种子歌曲,生成个性化推荐列表,并提供基于Flask的Web接口供前端调用。\n\n从计算机系统服务的视角看,系统还需具备一定程度的可运维性,包括采集任务的定时调度、服务接口的监控以及日志记录能力。\n\n## 三、系统总体设计\n\n系统采用分层架构,分为数据采集层、数据存储层、数据分析层、推荐算法层和服务接口层。\n\n- 数据采集层:以Scrapy为主框架,配合Requests与BeautifulSoup处理静态与该页面请求,加入随机User-Agent、请求间隔和代理池等反爬策略。\n- 数据存储层:采用MySQL存储结构化歌曲与用户行为数据,使用Redis缓存热门推荐结果与频繁访问的歌曲信息,MongoDB可用于存储歌词等非结构化文本。\n- 数据分析层:基于Pandas与NumPy完成数据清洗与特征构造,利用jieba进行歌词分词,并使用Matplotlib/Seaborn生成统计图表。\n- 推荐算法层:实现基于内容的推荐(TF-IDF与余弦相似度)和基于用户的协同过滤,并通过加权融合形成混合推荐。\n- 服务接口层:使用Flask提供RESTful接口,包括歌曲检索、热度榜单、相似歌曲推荐和个性化推荐等。\n\n## 四、数据采集模块实现\n\n### 4.1 爬虫框架选择\n\n对于结构清晰、页面列表分页明确的音乐站点,采用Scrapy定义Spider,设置DOWNLOAD_DELAY与并发数,编写Item Pipeline将数据写入MySQL。对于部分需要动态渲染的页面,辅以Selenium或Playwright进行加载后解析。\n\n### 4.2 字段定义与数据模型\n\n设计歌曲主数据表结构与常见字段:内部歌曲标识、歌名、歌手(支持多值)、专辑、时长(秒)、发行日期、语种、曲风标签、歌词、播放量、评论数、采集时间。统一定义字段后便于后续分析。(代码部分见下)
如若转载,请注明出处:http://www.mayizhiyun.com/product/44.html
更新时间:2026-10-28 00:13:05